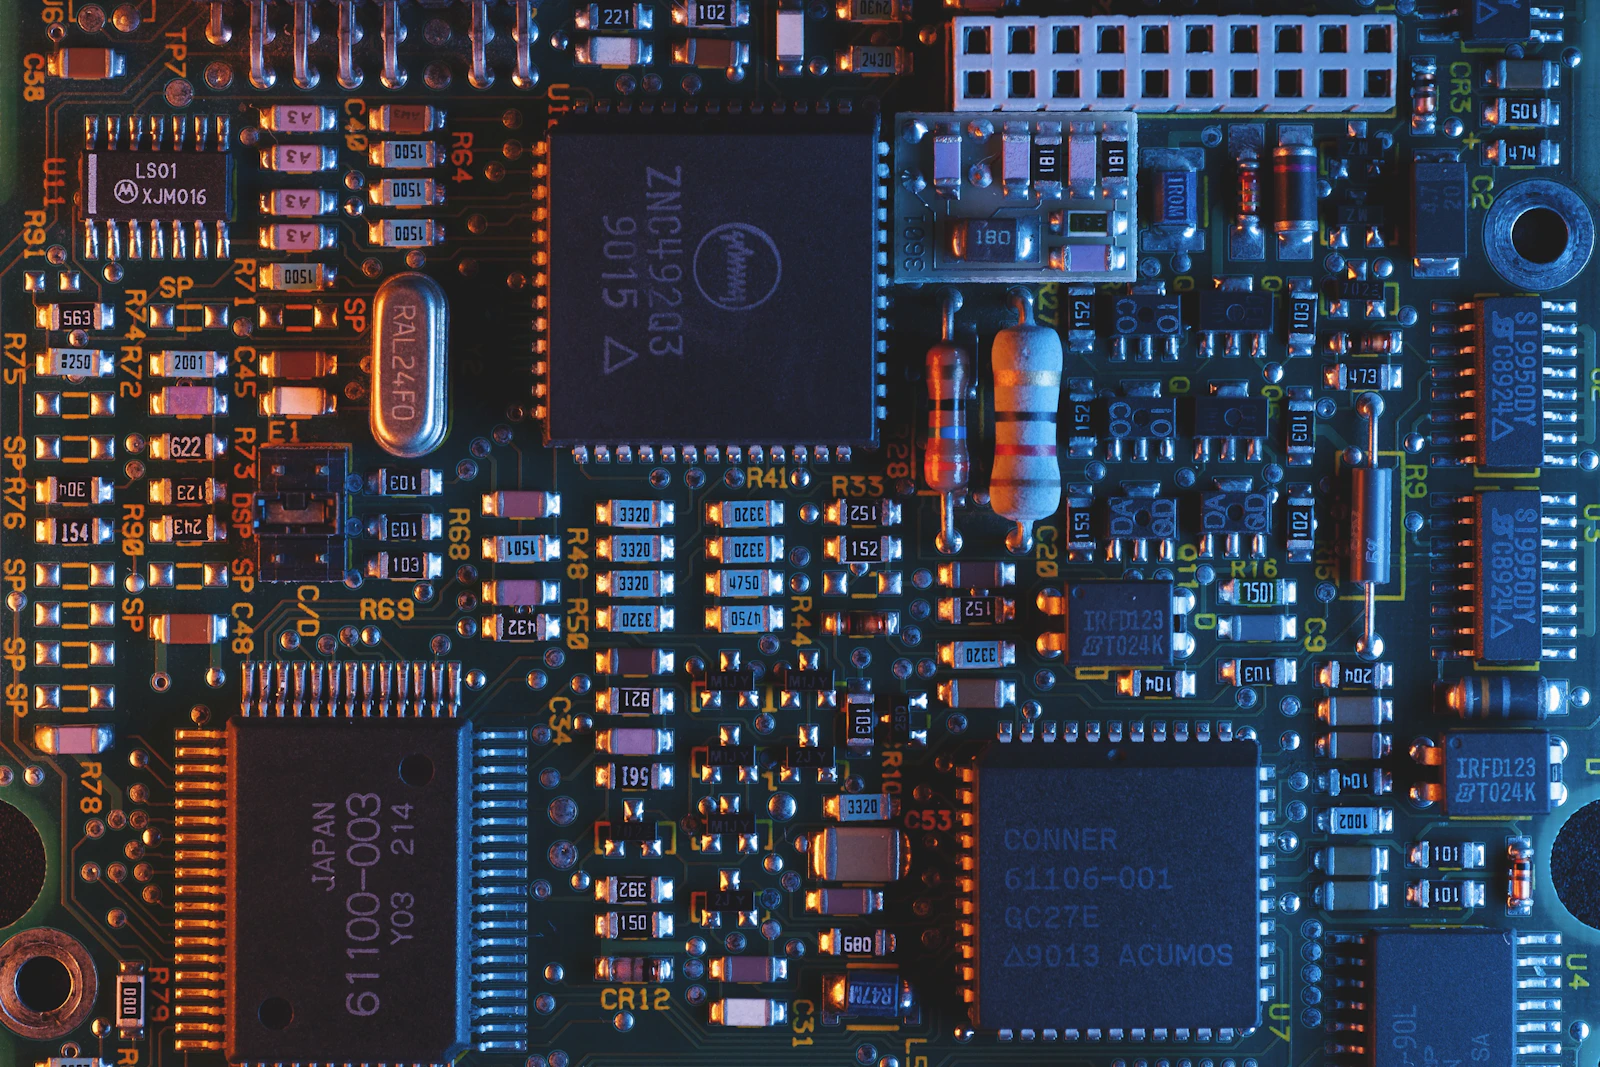
Setiap token yang keluar dari chatbot AI dimulai dengan langkah yang sama: GPU membaca ulang miliaran bobot model dari DRAM ke unit komputasinya, token demi token. Taalas, startup asal Toronto yang baru diakuisisi AMD, menghilangkan langkah itu sepenuhnya — dengan mengubah bobot model itu sendiri menjadi sirkuit fisik di dalam chip (Tech Times).
"Hard Coded Inference": model yang jadi hardware
AMD mengumumkan kesepakatan definitif untuk mengakuisisi Taalas pada 6 Agustus 2026. Startup ini, didirikan tahun 2023, menyebut pendekatannya Hard Coded Inference — alih-alih menyimpan bobot model di memori terpisah lalu memuatnya ke unit komputasi setiap kali menghasilkan token (cara kerja GPU konvensional), Taalas mengukir bobot itu langsung menjadi bagian dari sirkuit chip. Bobotnya bukan lagi data yang dibaca prosesor; bobot itu adalah prosesornya (The Register).
Chip pertama mereka, HC1, dibuat di proses TSMC N6 dan mengenkode seluruh model Llama 3.1 8B ke dalam mask ROM dengan sekitar 53 miliar transistor. Karena tidak ada lagi proses baca-tulis memori eksternal untuk mengambil bobot, latensi antar-token nyaris hilang — AMD mengklaim chip ini menghasilkan sekitar 17.000 token per detik per pengguna pada konsumsi daya sekitar 200 watt (SiliconANGLE).
Taalas didirikan tahun 2023 oleh Ljubisa Bajic, alumnus AMD yang sebelumnya menjabat CEO Tenstorrent, perusahaan desain chip AI lain. "Kami mendirikan Taalas untuk memikirkan ulang inferensi AI dari dasar — dengan membangun hardware di sekeliling modelnya, bukan sebaliknya," kata Bajic soal filosofi di balik pendekatan yang terbalik dari cara industri chip bekerja selama ini, di mana hardware biasanya dirancang generik dulu baru software/model menyesuaikan (CNBC).

Klaim kecepatan besar, dengan harga yang jelas
Angka yang dipasarkan AMD memang mencolok: 48 kali lebih cepat dibanding GPU Nvidia dan 8,5 kali lebih cepat dibanding chip Cerebras untuk beban kerja inferensi setara. Tapi kecepatan itu datang dengan kompromi yang tidak bisa ditawar — begitu bobot model dicetak ke dalam sirkuit, chip itu terkunci untuk satu model saja, selamanya. Chip yang dilatih untuk Llama 3.1 8B tidak bisa dipakai menjalankan model lain, apalagi versi model yang sudah di-fine-tune ulang (Next Platform).
Taalas mencoba meredam masalah ini dari sisi manufaktur: proses desainnya hanya perlu mengubah 2 dari sekitar 100 lapisan logam (metal layer) chip untuk setiap model baru, dan siklus produksi penuh di TSMC memakan waktu sekitar dua bulan. Itu jauh lebih cepat dari desain chip dari nol, tapi tetap jauh lebih lambat — dan lebih mahal per iterasi — dibanding cukup mengganti bobot lewat software di GPU biasa. Ini taruhan yang masuk akal hanya untuk model yang sudah stabil dan dipakai dalam volume sangat besar, bukan untuk eksperimen atau model yang sering diperbarui.

Kenapa AMD mau bertaruh di sini
Pergerakan ini masuk akal dalam konteks posisi AMD di pasar chip AI, di mana Nvidia masih mendominasi hampir seluruh pangsa pasar pelatihan model besar. AMD tampaknya memilih untuk tidak bersaing head-to-head di segmen itu, dan justru mengincar celah spesifik: perusahaan-perusahaan yang sudah punya satu atau dua model produksi dengan volume permintaan inferensi sangat tinggi dan stabil — kandidat sempurna untuk chip yang super cepat tapi tidak fleksibel. Financial terms dari akuisisi ini tidak diumumkan kedua perusahaan, dan transaksi diperkirakan rampung pada kuartal keempat 2026, menunggu persetujuan regulator (The Register).
CEO AMD Lisa Su sendiri sudah menyiapkan bingkai untuk akuisisi seperti ini beberapa minggu sebelumnya, saat berbicara di sebuah peluncuran produk pada Juli 2026: "Saya sangat percaya tidak ada satu jenis chip yang cocok untuk semua kebutuhan." Ia menambahkan bahwa GPU tetap akan mendominasi mayoritas pasar chip AI karena fleksibilitasnya untuk mendukung model-model baru yang terus bermunculan — sebuah pengakuan implisit bahwa Taalas bukan pengganti lini GPU AMD, melainkan pelengkap untuk kasus penggunaan sempit yang sudah matang.
Taruhan ini juga mencerminkan tekanan biaya inferensi yang makin nyata di seluruh industri. Selama fase pelatihan model mendominasi biaya AI, fleksibilitas GPU jelas lebih berharga daripada kecepatan mentah. Tapi begitu sebuah model produksi dipakai miliaran kali per hari — asisten suara, mesin rekomendasi, layanan chatbot skala konsumen — biaya listrik dan hardware untuk menjalankan inferensi itu berulang kali mulai melampaui biaya melatihnya sekali di awal. Chip sekali-pakai-per-model jadi masuk akal secara ekonomi persis di titik itu.
Takeaway
AMD tidak membeli Taalas untuk menyaingi Nvidia di semua lini — mereka membeli jalan pintas ke satu segmen sempit tapi berpotensi sangat menguntungkan: inferensi model tunggal bervolume masif, di mana kecepatan mentah lebih berharga daripada kemampuan berganti model kapan saja. Taruhannya jelas: seiring makin banyak perusahaan mengunci satu model produksi untuk jangka panjang, kekakuan chip yang "dicetak sekali untuk satu model" akan terasa jauh lebih murah daripada terlihat di atas kertas.
---
Sumber gambar: Umberto di Unsplash Sumber gambar: Vishnu Mohanan di Unsplash Sumber gambar: imgix di Unsplash
The conversation 0
No comments yet. Start the conversation.